Wie nutze ich das VPS Rescue-System?

Das Rescue-System startet deinen Server in einem temporären Cloud-Server mit einem kleinen Linux. Deine eigentliche Festplatte hängt daneben und lässt sich mounten. So kommst du an deine Daten und reparierst das System, auch wenn es selbst nicht mehr startet.

Wann du es brauchst

  • Der Server bootet nicht mehr, zum Beispiel nach einem Fehler in /etc/fstab oder einem kaputten Kernel-Update.
  • Das Dateisystem ist nach einem Backup oder harten Stop inkonsistent und der Server hängt im initramfs. Siehe Server hängt im initramfs: Dateisystem mit fsck reparieren.
  • Dienste und Apps laufen nicht mehr oder der Server verhält sich unberechenbar, und du vermutest, dass die Festplatte voll ist. Siehe Speicherplatz prüfen und aufräumen.
  • Der Server läuft, ist aber nicht erreichbar, weil die IP-Adresse fehlt oder falsch ist, zum Beispiel bei einem eigenen Betriebssystem ohne cloud-init oder Guest Agent. Siehe Netzwerk-Konfiguration korrigieren.
  • Du hast dich ausgesperrt, etwa durch eine Firewall-Regel oder einen falschen SSH-Port, und die VNC-Konsole hilft nicht weiter.
  • Du willst Daten von einem defekten System retten, bevor du neu installierst.

Nur das Root-Passwort vergessen? Das setzt du ohne Rescue direkt im Cloud Manager zurück: Wie setze ich mein Root- oder Admin-Passwort zurück?

Rescue starten

  1. Im Cloud Manager unter „Aktionen“ im Bereich „Backups und Wiederherstellung“ auf „Rescue Modus aktivieren“ klicken.
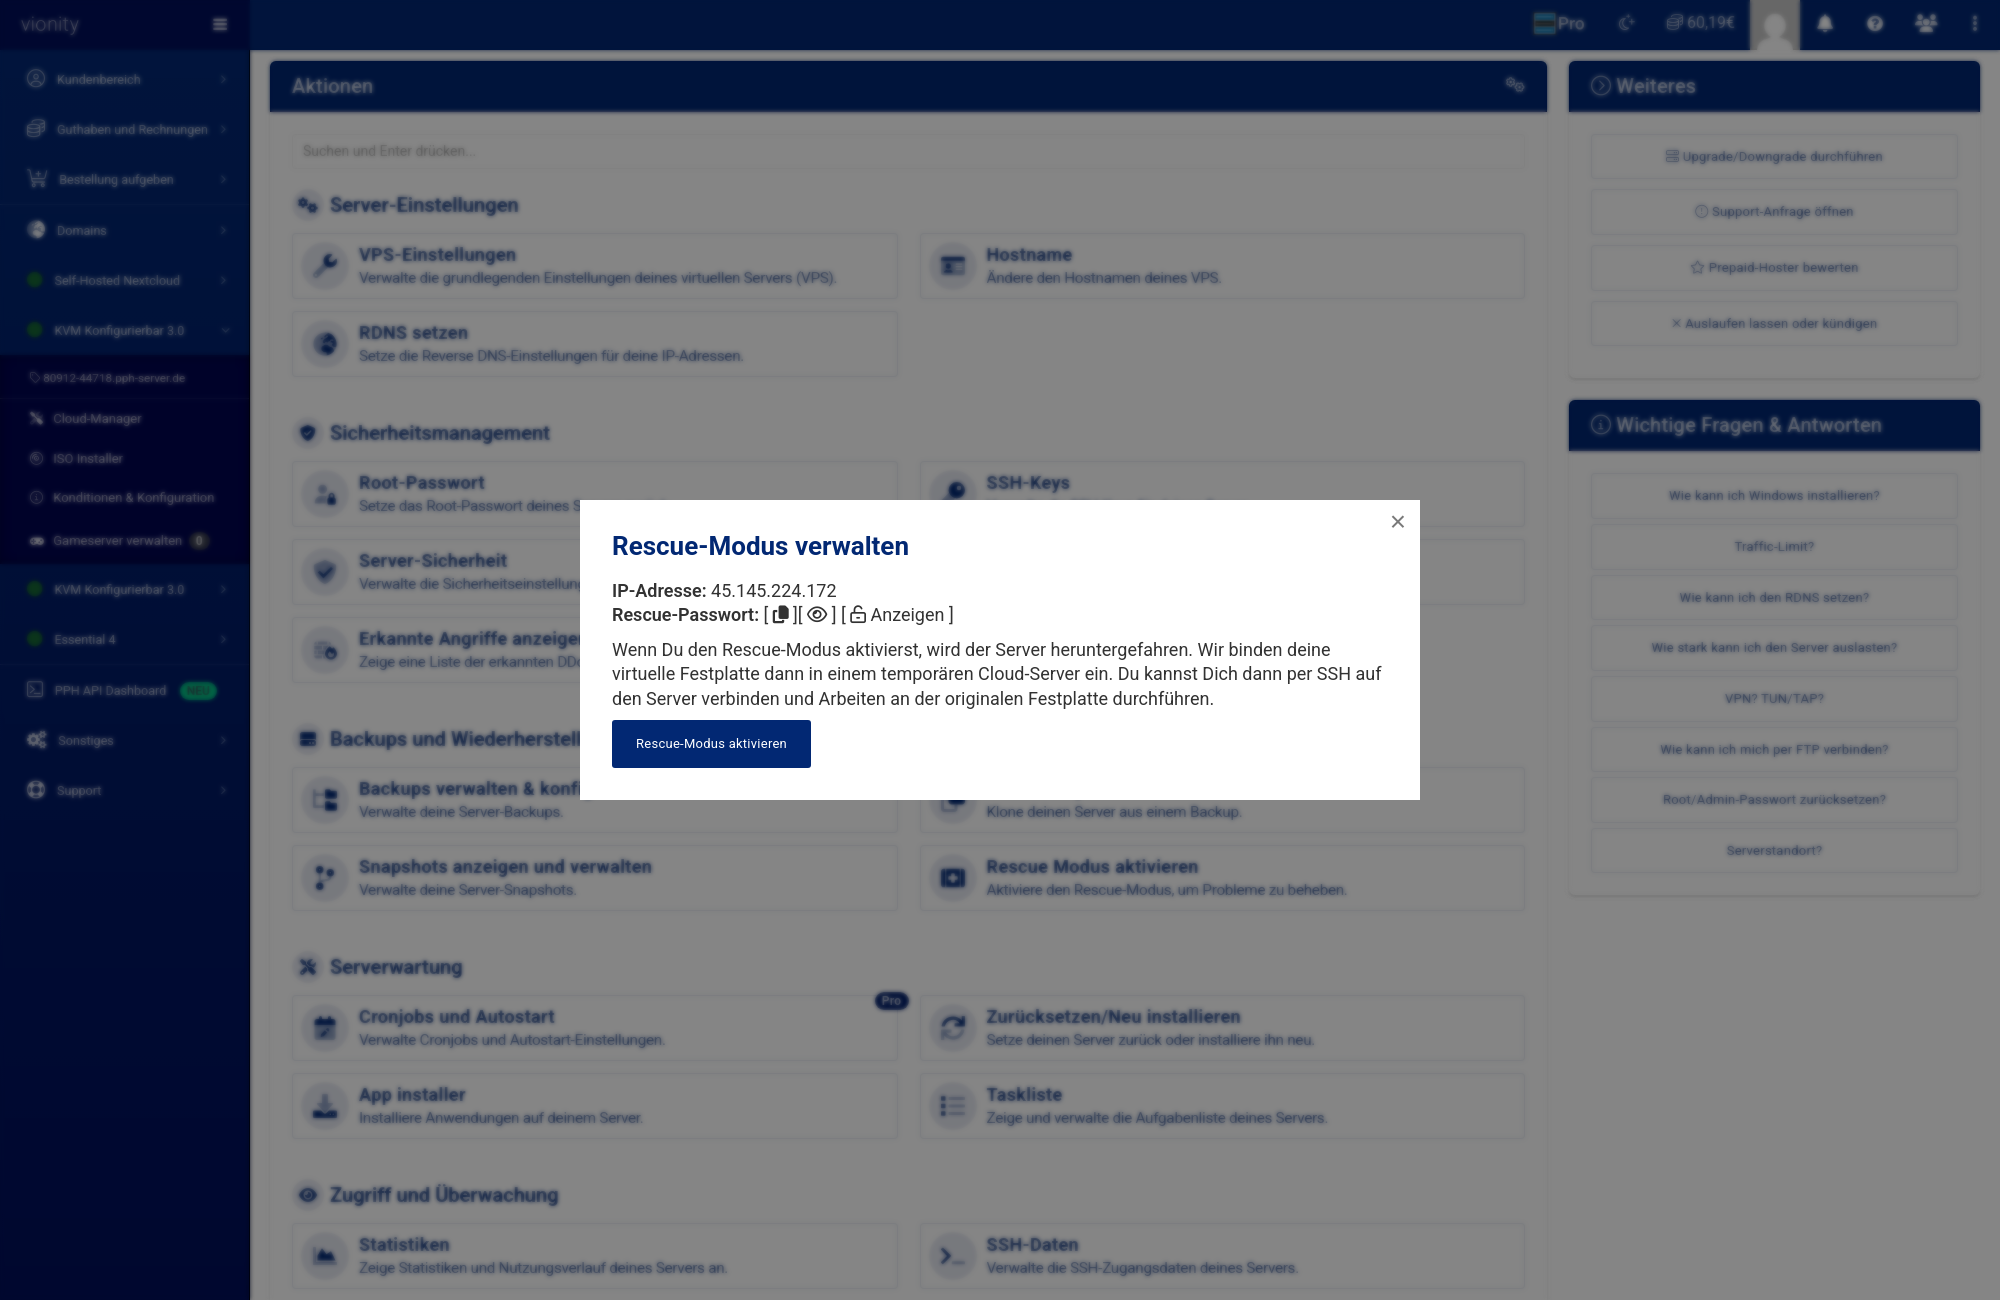
  2. Im Dialog „Rescue-Modus verwalten“ siehst du die IP-Adresse und unter „Anzeigen“ das Rescue-Passwort. Es ist das Standard-Passwort, das du bei der Bestellung vergeben hast.
  3. Auf „Rescue-Modus aktivieren“ klicken. Der Server wird heruntergefahren und deine Festplatte in einen temporären Cloud-Server eingebunden.
  4. Per SSH auf die angezeigte IP-Adresse verbinden, Benutzer root, Passwort wie im Dialog.
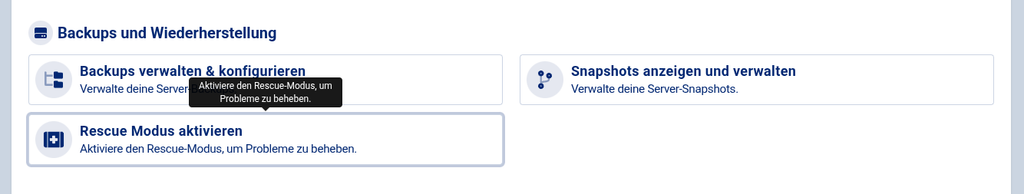
Hier findest du die Aktion: Resue Modus aktivieren im Cloud-Manager
Dialog Rescue-Modus verwalten mit IP-Adresse, Rescue-Passwort und Schaltfläche Rescue-Modus aktivieren
Der Dialog „Rescue-Modus verwalten“ im Cloud Manager

Deine Festplatte finden und mounten

Zuerst schaust du nach, welche Platte deine ist:

lsblk -f
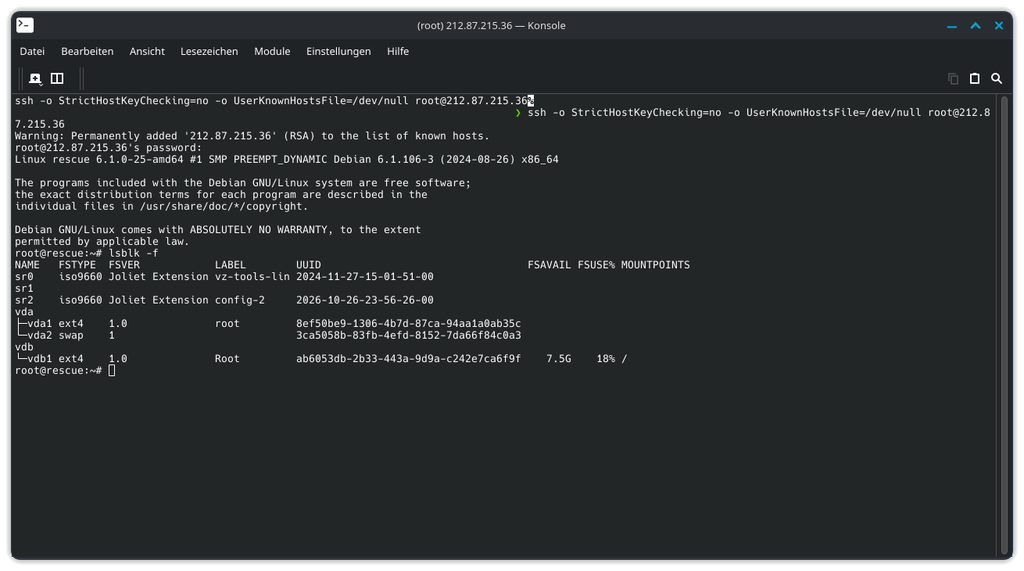
Aktives Rescuesystem und Auflistung der vorhandenen Partitionen

Deine eigene Platte ist in der Regel /dev/vda, bei manchen Servern /dev/sda. Das Rescue-System hängt als zusätzliche Platte dahinter, meist als /dev/vdb, und wird nur über die Boot-Reihenfolge gestartet. Es ist unter / eingehängt und hat 20 GB, daran erkennst du es. Deine Systempartition mountest du dann so (Beispiel mit vda1):

mount /dev/vda1 /mnt

Jetzt liegen deine Dateien unter /mnt. Eine falsche Zeile in der fstab korrigierst du zum Beispiel mit nano /mnt/etc/fstab.

Speicherplatz prüfen und aufräumen

Wirf nach dem Mounten immer auch einen Blick auf den Speicherplatz. Ein voller Speicher führt zu unvorhersehbaren Abstürzen: Dienste starten nicht mehr, Datenbanken brechen ab, Anmeldungen schlagen fehl, und im schlimmsten Fall bootet das System gar nicht mehr. Von außen sieht das oft aus, als wäre der Server komplett ausgefallen.

df -h /mnt
df -i /mnt

Die erste Zeile zeigt den belegten Platz, die zweite die belegten Inodes. Auch bei freiem Platz kann das Dateisystem voll sein, wenn die Inodes aufgebraucht sind, etwa durch Millionen kleiner Dateien. Steht bei „Use%“ oder „IUse%“ etwas um 100 %, hast du den Übeltäter gefunden. Die größten Verzeichnisse findest du so:

du -xh /mnt --max-depth=2 2>/dev/null | sort -h | tail -20

Typische Platzfresser sind /var/log und das Journal unter /var/log/journal, /var/lib/docker, alte Backups und Datenbank-Dumps, Mail-Queues und der Paket-Cache. Lösche nur, was du eindeutig zuordnen kannst. Den Paket-Cache räumst du am einfachsten in der chroot auf (siehe nächster Abschnitt), unter Debian und Ubuntu mit apt clean.

Brauchst du den Platz, aber willst die Daten nicht löschen, lagere sie aus. Die Rescue-Platte hat nur 20 GB, deshalb kopierst du größere Mengen besser direkt auf einen anderen Server, per rsync oder scp:

rsync -avz --progress /mnt/var/backups/ user@backup.example.com:/pfad/zum/ziel/

Lösche die Originale erst, wenn du geprüft hast, dass die Kopie vollständig angekommen ist. Wie du Daten auf deinen eigenen Rechner holst, steht im Abschnitt „Daten herunterladen“. Plane danach, wie der Speicher nicht wieder volläuft, zum Beispiel mit Logrotate und einem regelmäßigen Blick auf df -h.

Im eigenen System arbeiten (chroot)

Für Befehle, die im eigentlichen System laufen müssen, etwa passwd, update-grub oder das Entfernen eines Pakets:

for d in dev proc sys; do mount --bind /$d /mnt/$d; done
chroot /mnt

Mit exit verlässt du die chroot wieder.

Netzwerk-Konfiguration korrigieren

Läuft dein Server, ist aber nicht erreichbar, liegt es oft an der Netzwerk-Konfiguration im System. Bei unseren Standard-Images setzen cloud-init, der Guest Agent oder Start-Skripte die IP-Adresse automatisch. Bei einem eigenen Betriebssystem, etwa per eigenem ISO installiert, fehlt das. Eine vergessene oder falsche IP-Adresse fällt dann nicht auf, und der Server ist von außen nicht erreichbar. Das korrigierst du im Rescue-Modus. Unter Debian und anderen Systemen mit ifupdown liegt die Konfiguration in /etc/network/interfaces:

nano /mnt/etc/network/interfaces

Ein Beispiel für eine statische Konfiguration mit IPv4 und IPv6 (Beispieldaten):

# The loopback network interface
auto lo
iface lo inet loopback

# The primary network interface
auto eth0
iface eth0 inet static
        address 62.68.75.69
        netmask 255.255.255.0
        broadcast +
        up route -A inet add 62.68.75.1 dev eth0
        up route -A inet add default gw 62.68.75.1 dev eth0

iface eth0 inet6 static
        pre-down ip -6 addr flush dev eth0 scope global || :
        address 2a12:edc0:1337::1
        netmask 45
        up route -A inet6 add fe80::1 dev eth0
        up route -A inet6 add default gw fe80::1 dev eth0

IP-Adresse, Netzmaske und Gateway müssen zu deinem Server passen. Trage deine eigenen Werte ein und kopiere das Beispiel nicht blind. Der Name der Schnittstelle (hier eth0) kann bei dir anders lauten, zum Beispiel ens3. Andere Systeme nutzen andere Dateien, etwa Netplan unter /etc/netplan/ oder systemd-networkd unter /etc/systemd/network/. Danach beendest du Rescue wie unten beschrieben, und der Server startet mit der neuen Konfiguration.

Daten herunterladen

Auf deinem eigenen Rechner holst du Daten per scp oder rsync aus /mnt, mit der IP-Adresse aus dem Rescue-Dialog:

rsync -avz root@62.68.75.69:/mnt/var/www/ ./www-sicherung/

Die Rescue-Platte hat 20 GB, falls du dort Daten zwischenlagern willst. Mehr gibt es auf Anfrage, wenn du einen guten Grund hast.

Rescue beenden

Hänge deine Platte vorher sauber aus (umount -R /mnt) und deaktiviere den Rescue-Modus dann im selben Dialog im Cloud Manager. Der Server startet wieder von seiner eigenen Platte. Vergiss das nicht: Solange Rescue aktiv ist, laufen deine Dienste nicht.
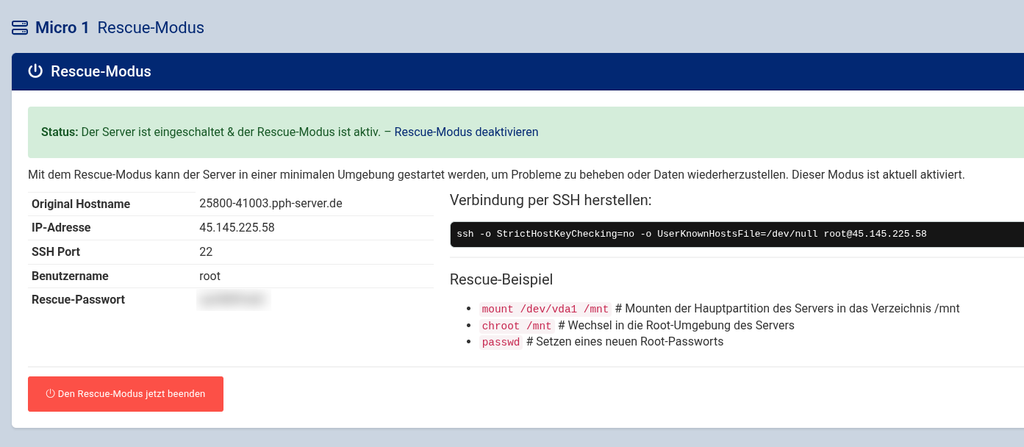
Das aktive Rescue-Panel. Hier siehst du alles wichtige für die Reparatur und für den Abschluss.

Klappt etwas auf unserer Seite nicht, zum Beispiel startet der Rescue-Modus gar nicht, melde dich im Support: Wie öffne ich ein Support-Ticket?
Wie spiele ich ein Backup wieder ein?

Im Cloud Manager wählst du eines deiner bis zu drei Backups aus und spielst es auf deinen Server zurück. Alternativ überträgst du es auf einen anderen deiner Server oder lädst es herunter. Dafür musst du nichts bezahlen und kein Ticket schreiben.

Vorher kurz nachdenken

Ein Restore überschreibt die komplette Festplatte. Alles, was nach dem Backup entstanden ist, geht verloren. Hast du seitdem neue Daten (Uploads, Mails, Datenbankeinträge), kopiere sie vorher weg. Startet der Server nicht mehr, kommst du über den Rescue-Modus trotzdem an deine Dateien.

Welches Backup wann entstanden ist, siehst du in der Liste mit Name, Größe und Datum. Nimm das letzte, bei dem noch alles in Ordnung war, nicht automatisch das neueste. Backups werden 90 Tage nach ihrer Erstellung automatisch entfernt.

Auf denselben Server zurückspielen

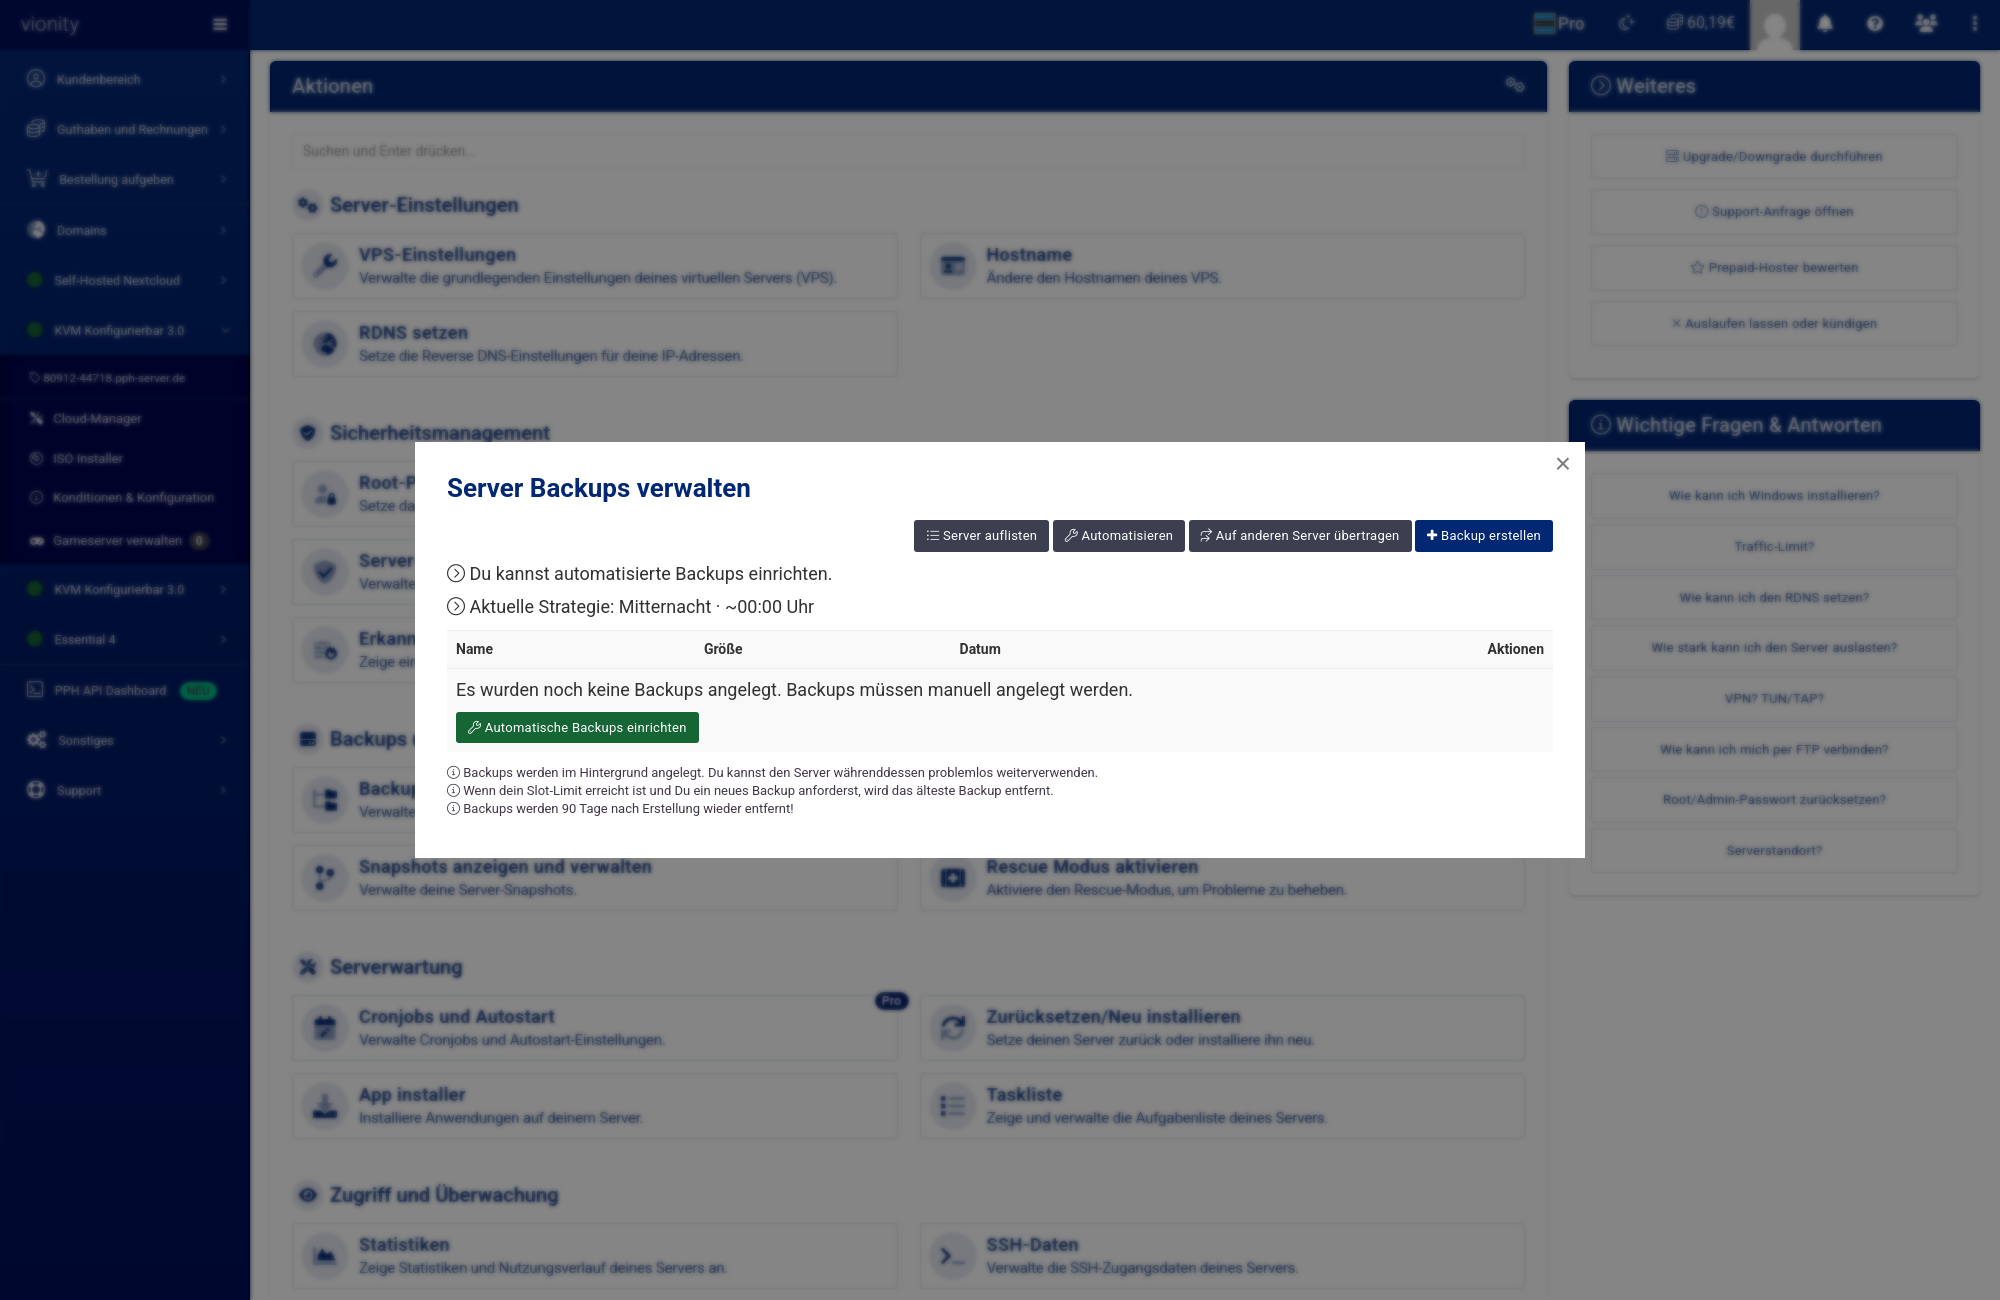
  1. Im Cloud Manager unter „Aktionen“ im Bereich „Backups und Wiederherstellung“ auf „Backups verwalten & konfigurieren“ klicken. Es öffnet sich der Dialog „Server Backups verwalten“.
  2. Beim gewünschten Backup in der Spalte „Aktionen“ die Wiederherstellung starten und bestätigen.
  3. Warten, bis der Vorgang fertig ist. Der Server startet danach mit dem alten Stand. Den Fortschritt siehst du in der Taskliste.
Dialog Server Backups verwalten mit den Schaltflächen Automatisieren, Auf anderen Server übertragen und Backup erstellen
Der Dialog „Server Backups verwalten“ im Cloud Manager

Wie lange dauert das? Das hängt vor allem von der Größe deiner Festplatte ab. Wir laden das Backup zuerst herunter, entpacken es und schieben die Platte dann in deinen Server. Das läuft mit niedriger Priorität, damit andere Server auf dem Host nicht leiden. Meist dauert ein Restore 3 bis 7 Minuten, bei großen Platten auch fast eine Stunde. Bring also etwas Zeit mit. Startet der Server danach nur bis zur Konsole (initramfs), hilft Server hängt im initramfs: Dateisystem mit fsck reparieren.

Auf einen anderen Server übertragen

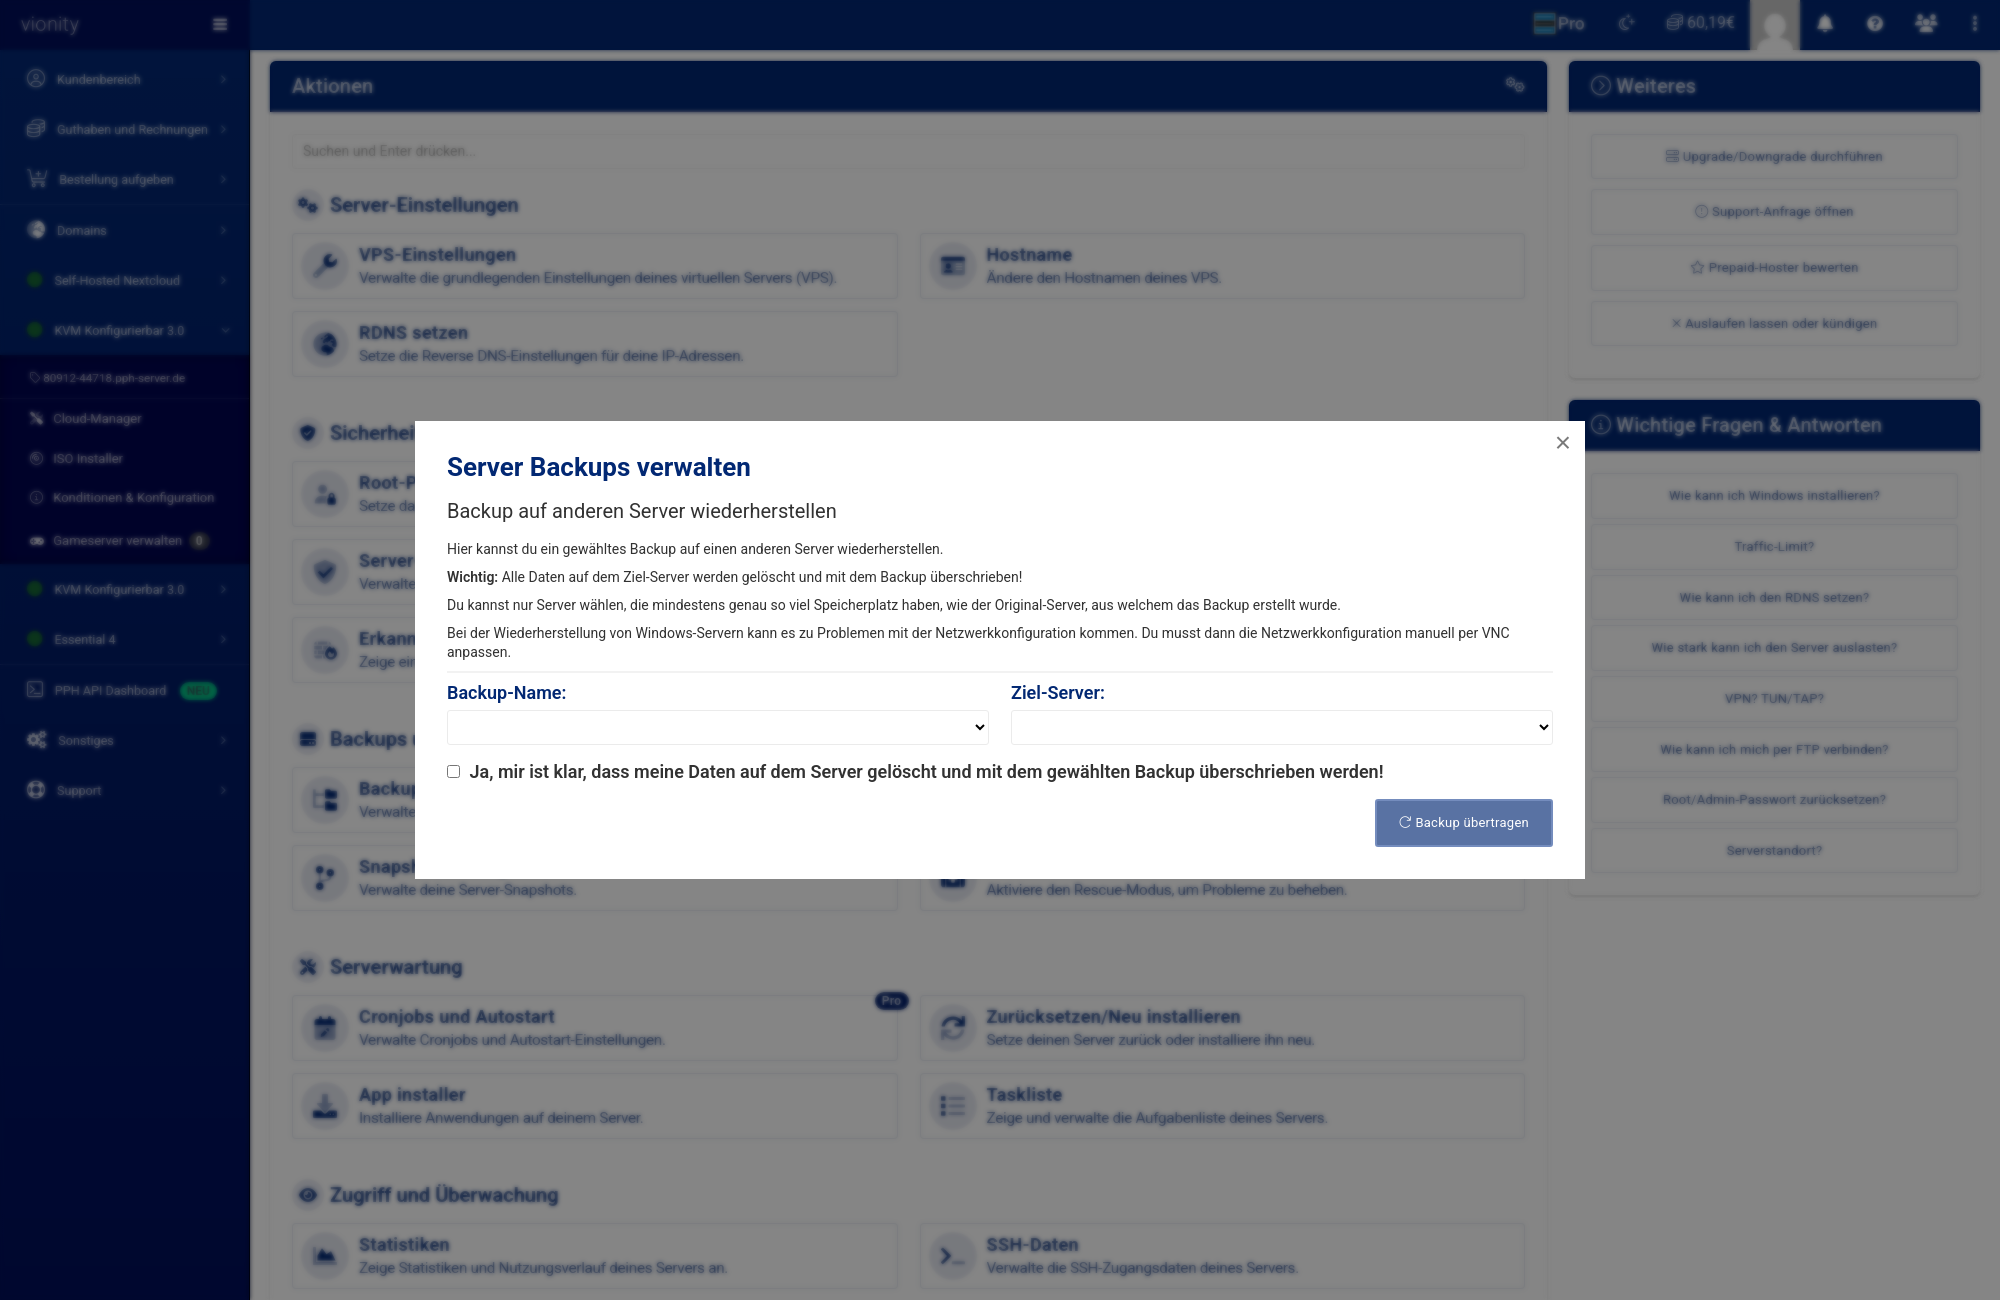
Du kannst ein Backup auch auf einen anderen deiner Server spielen, zum Beispiel um ihn zu klonen oder auf ein größeres Paket umzuziehen. Im Dialog „Server Backups verwalten“ klickst du dazu auf „Auf anderen Server übertragen“, wählst Backup und Ziel-Server, bestätigst die Sicherheitsabfrage und klickst auf „Backup übertragen“.

  • Alle Daten auf dem Ziel-Server werden gelöscht und mit dem Backup überschrieben.
  • Der Ziel-Server braucht mindestens so viel Speicherplatz wie der Server, von dem das Backup stammt.
  • Bei Windows-Servern kann danach die Netzwerkkonfiguration nicht stimmen. Die passt du dann per VNC an.
Dialog Backup auf anderen Server wiederherstellen mit Auswahl von Backup-Name und Ziel-Server
Backup auf einen anderen Server wiederherstellen

Die ausführliche Anleitung mit allen Schritten steht in Wie kann ich meinen Server klonen?

Bei Smart Essential gibt es das Übertragen auf einen anderen Server im Webinterface noch nicht. Dort spielst du ein Backup über die Oberfläche nur auf denselben Server zurück. Auf einen anderen Server geht es per API, alternativ erledigt das der Support für dich.

Backup herunterladen

Jedes Backup kannst du als Festplatten-Abbild im Format qcow2 herunterladen. Damit hast du eine Kopie außerhalb unserer Infrastruktur und kannst deine Daten jederzeit mitnehmen.

Wieder hochladen geht nicht. Ein heruntergeladenes Abbild spielen wir nicht zurück auf unsere Server, weder im Webinterface noch über den Support. Hat ein Abbild unsere Infrastruktur einmal verlassen, können wir nicht mehr prüfen, ob es verändert wurde, und fremde Abbilder binden wir aus Sicherheitsgründen nicht auf unseren Hosts ein. Zurückspielen kannst du nur Backups, die noch bei uns in der Liste stehen. Ist dein Server gelöscht, sind auch seine Backups bei uns weg.

Brauchst du die Daten aus einem heruntergeladenen Backup, holst du sie aus dem Abbild heraus und kopierst sie auf deinen neuen Server. Unter Linux bindest du das Abbild dazu schreibgeschützt ein:

sudo modprobe nbd max_part=8
sudo qemu-nbd --connect=/dev/nbd0 /pfad/zum/abbild
lsblk
sudo mount -o ro /dev/nbd0p1 /mnt

Mit lsblk siehst du, welche Partition deine Daten enthält, meist /dev/nbd0p1. Danach liegt dein altes Dateisystem unter /mnt. Pack die Dateien, Configs und Datenbank-Dumps, die du brauchst, in ein Archiv und lade nur das auf den neuen Server. Zum Schluss hängst du das Abbild wieder aus:

sudo umount /mnt
sudo qemu-nbd --disconnect /dev/nbd0

Hast du kein Linux zur Hand, kopierst du das Abbild per scp oder rsync auf einen neuen vServer und bindest es dort genauso ein. Der neue Server braucht dann Platz für das Abbild und zusätzlich für die Daten, die du daraus übernimmst.

Keine Backups da?

Automatische Backups musst du einmal einrichten: Automatische Backups aktivieren bei Prepaid Hoster. Ist kein Backup vorhanden, können wir auch keines herbeizaubern.

Vor größeren Änderungen legst du mit „Backup erstellen“ zusätzlich von Hand ein Backup an. Das läuft im Hintergrund, du kannst den Server währenddessen normal weiterverwenden. Ist dein Slot-Limit erreicht, wird dabei das älteste Backup entfernt. Für einen schnellen Rückweg in den nächsten Stunden gibt es außerdem Snapshots.

Wie erstelle ich einen Snapshot und spiele ihn zurück?

Ein Snapshot friert den Stand deines Servers auf Knopfdruck ein. Geht danach etwas schief, springst du mit einem Klick zurück. Du legst ihn im Cloud Manager an, bevor du etwas änderst, das dein System zerlegen könnte.

Snapshot oder Backup?

SnapshotBackup
Wannvon Hand, sofortautomatisch im gewählten Zeitfenster
Wofürkurzer Rückweg vor einer ÄnderungAbsicherung gegen Datenverlust
Anzahl2 pro Server, mit Prepaid Hoster Pro 43 pro Server
Speicherortauf demselben Host wie dein Servergetrennter Speicher in Deutschland oder Finnland

Ein Snapshot ersetzt kein Backup. Er liegt auf demselben Host wie dein Server und hilft dir nicht, wenn dieser Host ausfällt. Außerdem löschen wir Snapshots nach 48 Stunden automatisch. Er ist dein „Strg+Z“ für die nächsten Stunden, das Backup ist deine Versicherung.

Typische Anlässe

  • Distributions-Upgrade, zum Beispiel Debian 12 auf 13
  • Änderungen an Firewall, SSH oder Netzwerk
  • Größere Updates von Nextcloud, Mailcow oder deiner eigenen Anwendung

Snapshot anlegen

  1. Melde dich im Webinterface an und öffne den Cloud Manager deines Servers.
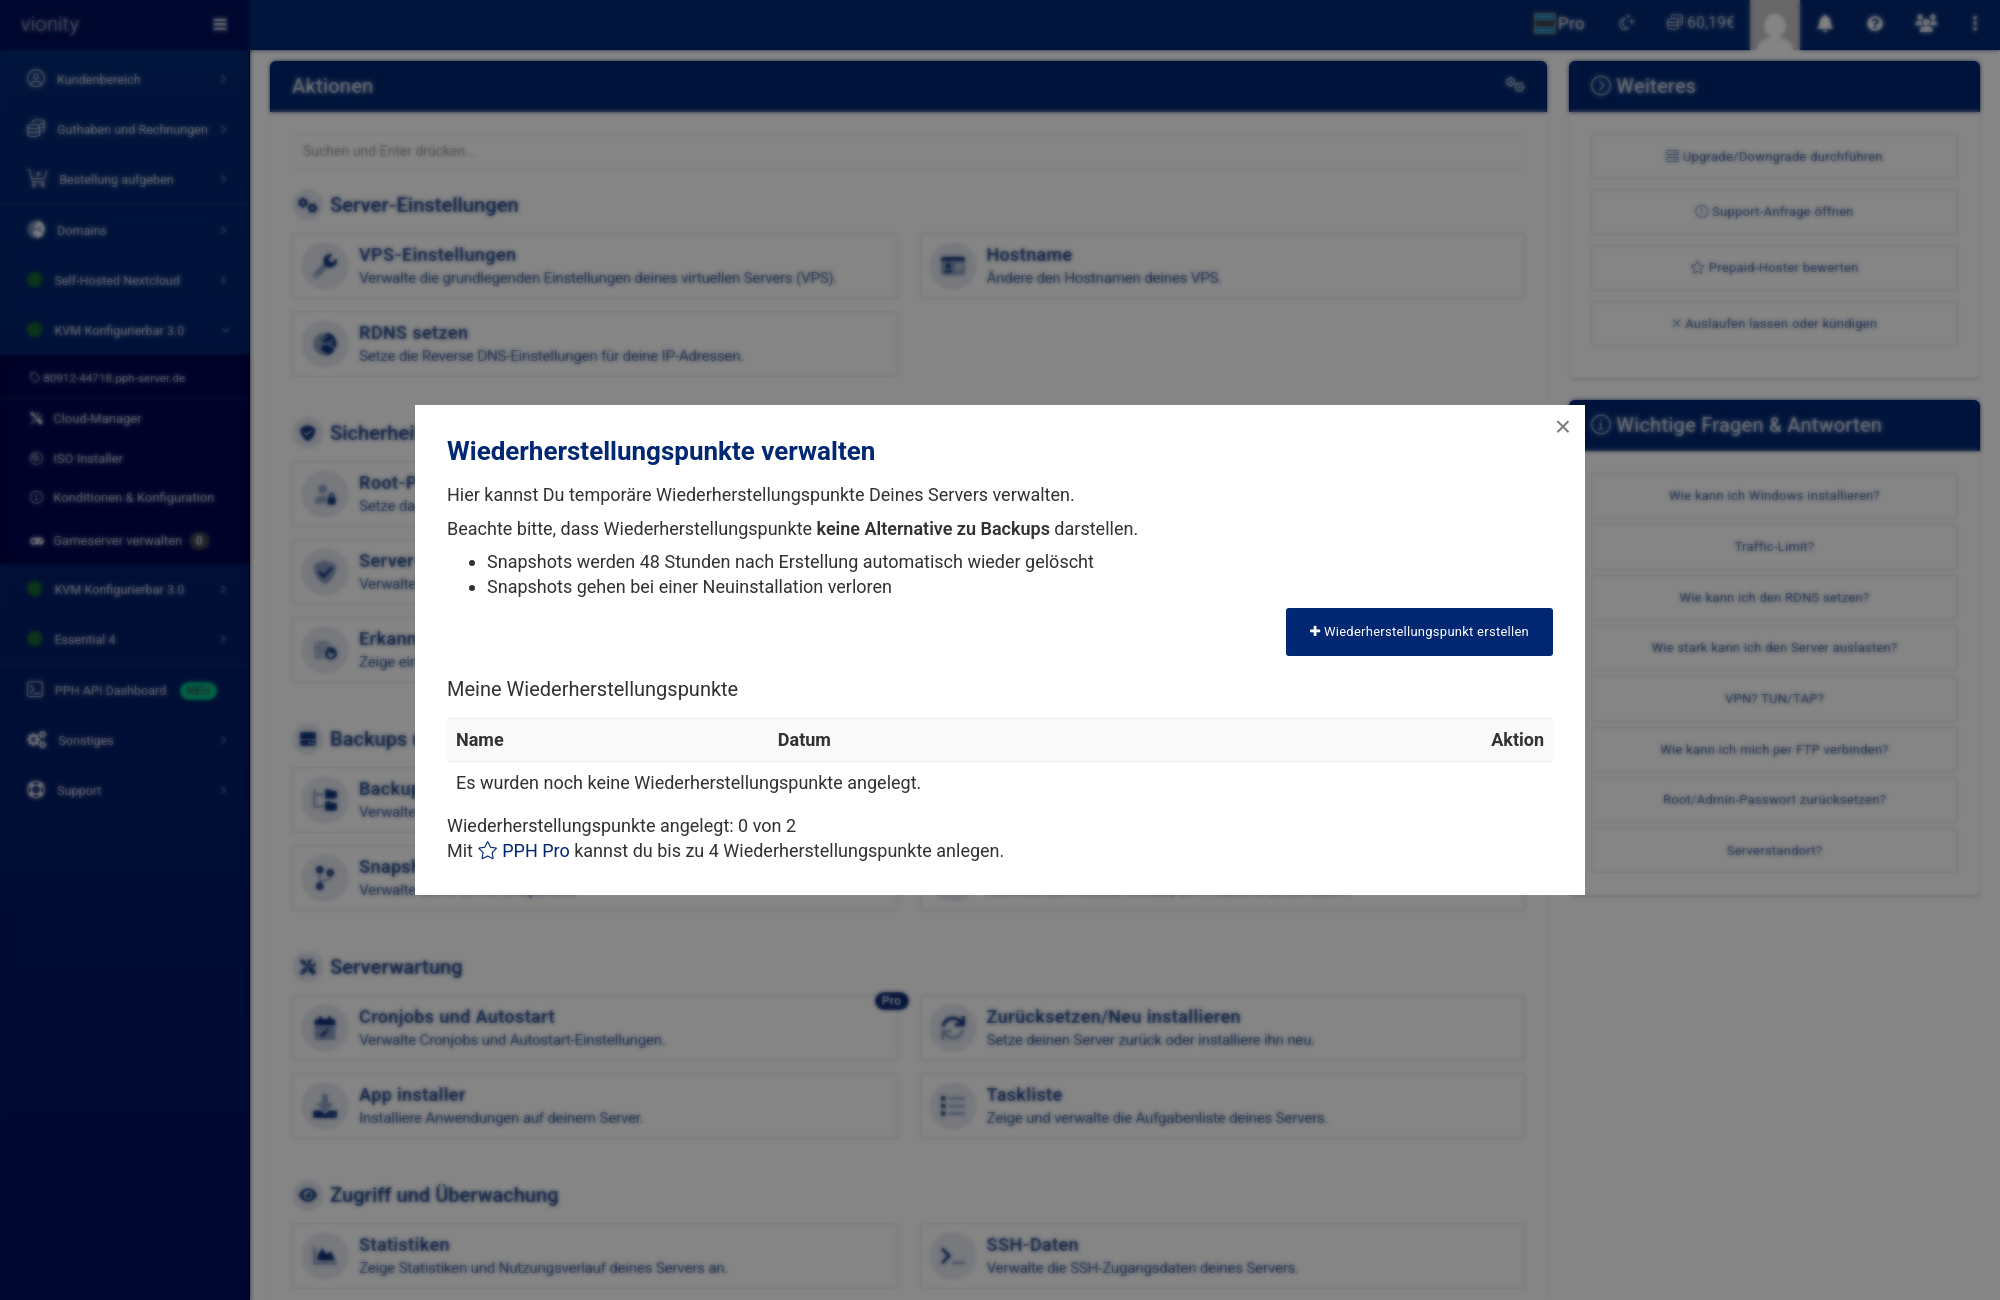
  2. Unter „Aktionen“ im Bereich „Backups und Wiederherstellung“ klickst du auf „Snapshots anzeigen und verwalten“. Im Dialog „Wiederherstellungspunkte verwalten“ klickst du auf „Wiederherstellungspunkt erstellen“.
  3. Gib ihm einen Namen, an dem du ihn später erkennst, etwa vor-debian-13.
Dialog Wiederherstellungspunkte verwalten im Cloud Manager mit Schaltfläche Wiederherstellungspunkt erstellen
Snapshots heißen im Cloud Manager Wiederherstellungspunkte.

Dein Server läuft währenddessen weiter. Wie lange es dauert, hängt von der Auslastung des Hosts und vom Arbeitsspeicher deines Servers ab.

Bei einer Datenbank mit vielen Schreibzugriffen stoppst du den Dienst vorher kurz oder fährst den Server herunter. Dann ist der Stand garantiert sauber.

Snapshot zurückspielen

Im selben Menü wählst du den Snapshot und stellst ihn wieder her. Dabei kann der Server kurz nicht erreichbar sein. Achtung: Alles, was seit dem Snapshot auf dem Server passiert ist, ist danach weg. Sichere neue Daten vorher woanders hin.

Aufräumen

Snapshots werden 48 Stunden nach dem Anlegen automatisch gelöscht. Bei einer Neuinstallation des Servers gehen sie sofort verloren. Sind alle Plätze belegt, löschst du einen alten Snapshot, bevor du einen neuen anlegst.

Für die dauerhafte Absicherung richtest du automatische Backups ein: Automatische Backups aktivieren bei Prepaid Hoster. Wie du ein Backup zurückspielst, steht in Wie spiele ich ein Backup wieder ein?

Wie richte ich HTTPS mit nginx und Let’s Encrypt ein?

Mit nginx und Certbot hat deine Domain in etwa zehn Minuten ein kostenloses Zertifikat von Let’s Encrypt, das sich selbst verlängert. Du brauchst einen Linux-vServer mit Debian oder Ubuntu, Root-Zugang und eine Domain. Diese Anleitung gilt für deinen eigenen Server. Für Webhosting mit Plesk nimmst du Wie erhalte ich ein kostenloses SSL Zertifikat für meine Domain?

1. Domain auf den Server zeigen lassen

Lege für deine Domain einen A-Eintrag mit der IPv4-Adresse deines Servers an, bei IPv6 zusätzlich einen AAAA-Eintrag. Liegt die Domain bei uns, geht das mit einem Klick über „Mit PPH Server verbinden“. Wie das funktioniert, steht in Wie kann ich meine Domain mit meinem vServer verbinden?

Prüfe auf dem Server, ob der Eintrag schon greift:

getent hosts example.de

Erst wenn hier die IP deines Servers steht, geht es weiter. Sonst schlägt Certbot fehl. Warum eine DNS-Änderung manchmal dauert, erklärt Warum dauert ein DNS-Update so lange?

2. nginx und Certbot installieren

apt update
apt install nginx certbot python3-certbot-nginx

Läuft schon Apache, etwa aus den Webserver-Utilities des App-Installers, belegt er Port 80. Dann stoppst und entfernst du Apache entweder, oder du nutzt Certbot direkt mit Apache (Paket python3-certbot-apache).

3. Seite anlegen

Lege die Datei /etc/nginx/sites-available/example.de an:

server {
    listen 80;
    listen [::]:80;
    server_name example.de www.example.de;
    root /var/www/example.de;
    index index.html;
}

Aktivieren und prüfen:

mkdir -p /var/www/example.de
ln -s /etc/nginx/sites-available/example.de /etc/nginx/sites-enabled/
nginx -t && systemctl reload nginx

4. Zertifikat holen

certbot --nginx -d example.de -d www.example.de

Certbot fragt nach einer E-Mail-Adresse für Ablaufwarnungen, holt das Zertifikat und trägt es in deine nginx-Konfiguration ein. Die Weiterleitung von HTTP auf HTTPS richtet er gleich mit ein.

5. Verlängerung prüfen

Zertifikate von Let’s Encrypt gelten 90 Tage. Certbot verlängert sie automatisch über einen systemd-Timer. Teste einmal, ob das klappt:

certbot renew --dry-run

Klappt nicht?

  • „Connection refused“ oder Timeout: Port 80 muss von außen erreichbar sein. Von uns aus sind alle Ports offen (Sind alle Ports freigegeben?). Hast du selbst eine Firewall eingerichtet, prüfe sie mit ufw status oder nft list ruleset.
  • Falsche IP: Der DNS-Eintrag zeigt noch woanders hin. Warten oder den Eintrag korrigieren.
  • Zu viele Versuche: Let’s Encrypt begrenzt fehlgeschlagene Versuche. Teste mit --dry-run, bis alles passt.

DNS-Records per API verwalten

So liest, setzt und pflegst du DNS-Einträge per API. Im Mittelpunkt steht der Upsert, mit dem du einen Record in einem einzigen Aufruf anlegst oder aktualisierst. Am Ende steht ein fertiges DynDNS-Skript zum Kopieren.

  • Records auflisten und einzeln pflegen
  • Upsert: anlegen oder aktualisieren in einem Schritt
  • Ganze Zonen exportieren und importieren

In allen Beispielen steht deine-domain.de für deine Domain und sk_live_XXXX für deinen Token. Als IDs kannst du überall die Domain oder ihre numerische ID verwenden.

Records auflisten

curl --request GET \
  --url https://api.pph.systems/api/domains/deine-domain.de/records \
  --header 'Accept: application/json' \
  --header 'Authorization: Bearer sk_live_XXXX'

Jeder Record kommt mit id, name, full_name, type, content, ttl und priority. Wichtig ist das Feld editable. Systemrecords wie NS und SOA stehen zwar in der Liste, sind aber nicht editierbar.

{
  "data": {
    "domain": "deine-domain.de",
    "records": [
      {
        "id": 101,
        "name": "www",
        "full_name": "www.deine-domain.de",
        "type": "A",
        "content": "192.0.2.1",
        "ttl": 300,
        "editable": true,
        "priority": null
      }
    ],
    "total": 1
  }
}

Mit dem Parameter name filterst du auf einen bestimmten Recordnamen, mit editable=true blendest du die Systemrecords aus.

Upsert: anlegen oder aktualisieren

Der Upsert ist das nützlichste Werkzeug für Automatisierung. Du gibst Name, Typ und Wert an. Existiert bereits ein Record mit diesem Namen und Typ, wird er aktualisiert. Wenn nicht, wird er angelegt. Du musst also vorher nicht prüfen, ob der Record schon da ist.

curl --request PATCH \
  --url https://api.pph.systems/api/domains/deine-domain.de/record/upsert \
  --header 'Accept: application/json' \
  --header 'Authorization: Bearer sk_live_XXXX' \
  --header 'Content-Type: application/json' \
  --data '{ "record_name": "home", "record_type": "A", "record_content": "192.0.2.10" }'

Beim ersten Aufruf wird der Record angelegt:

{
  "data": { "updated": [ { "id": 456439, "type": "A", "content": "192.0.2.10", "ttl": 43200 } ] },
  "message": "DNS record created successfully."
}

Rufst du dieselbe Kombination aus Name und Typ mit einem neuen Wert erneut auf, bleibt die id gleich und nur der Inhalt ändert sich. Der Text in message wechselt auf „updated“:

{
  "data": { "updated": [ { "id": 456439, "type": "A", "content": "192.0.2.20", "ttl": 43200 } ] },
  "message": "DNS record(s) updated successfully."
}

Optional kannst du record_ttl mitgeben, und bei MX– oder SRV-Records record_prio.

Einzelne Records gezielt bearbeiten

Wenn du einen bestimmten Record über seine ID ansprechen willst, gibt es drei weitere Routen:

  • Anlegen: POST /domains/deine-domain.de/records. Mit replace_existing=true ersetzt du einen gleichnamigen Record, statt einen Fehler zu bekommen.
  • Ändern: Über die Record-ID änderst du gezielt Wert, Name, Typ, TTL oder Priorität eines einzelnen Records.
  • Löschen: Über die Record-ID entfernst du einen einzelnen Record.

Für die meisten Automatisierungen reicht der Upsert. Die ID-basierten Routen brauchst du, wenn du mehrere gleichnamige Records desselben Typs getrennt verwalten musst.

Die ganze Zone exportieren

Für Backups, Versionierung oder eine Migration exportierst du die komplette Zone als BIND-Zonefile.

curl --request GET \
  --url https://api.pph.systems/api/domains/deine-domain.de/records/export \
  --header 'Accept: text/plain' \
  --header 'Authorization: Bearer sk_live_XXXX'

Du erhältst ein Standard-Zonefile. Jeder Eintrag ist mit seiner Record-ID als Kommentar versehen.

$ORIGIN deine-domain.de.
$TTL 300
; #101
www	IN	A	192.0.2.1
; #102
@	IN	MX	10 mail.deine-domain.de.
; #103
@	IN	TXT	"v=spf1 mx -all"

Ohne den Header Accept: text/plain bekommst du dieselbe Zone als JSON zurück.

Eine ganze Zone importieren

Mit dem Import spielst du eine komplette Zone aus einem Zonefile ein. Achtung: Der Import ist ein vollständiger Ersatz. Records, die nicht im Zonefile stehen, werden entfernt.

Deshalb läuft der Import standardmäßig als Testlauf (dry). Dabei wird nichts geändert, sondern nur geprüft, was passieren würde.

curl --request POST \
  --url https://api.pph.systems/api/domains/deine-domain.de/records/import \
  --header 'Accept: application/json' \
  --header 'Authorization: Bearer sk_live_XXXX' \
  --header 'Content-Type: application/json' \
  --data '{
    "dry": true,
    "zonefile": "$ORIGIN deine-domain.de.\n$TTL 300\n@ IN A 192.0.2.1\nwww IN A 192.0.2.1\n"
  }'

Die Antwort zeigt dir die geparsten Records und bestätigt mit dry_run: true, dass noch nichts geändert wurde. Prüfe dieses Ergebnis. Erst wenn es passt, wiederholst du den Aufruf mit "dry": false, um die Zone tatsächlich zu ersetzen.

DNSSEC (in Entwicklung)

Über die Registry-Routen kannst du die DNSSEC-Konfiguration einer Domain abfragen und die DS-Records am Registrar setzen. Der aktuelle Zustand sieht so aus:

{
  "dnssec": false,
  "dnssecData": [],
  "dnssec_available": false
}

dnssec_available zeigt, ob DNSSEC für die Domain nutzbar ist. Das setzt einen externen Nameserver-Setup voraus. Mit den Standard-Nameservern steht das Feld auf false.

Diese Routen sind noch nicht final dokumentiert und ihr Antwortformat kann sich ändern. Wenn du DNSSEC produktiv nutzen möchtest, sprich uns am besten kurz an.

Praxisbeispiel: ein DynDNS-Skript

Der Upsert eignet sich ideal für DynDNS. Das folgende Bash-Skript ermittelt deine öffentliche IPv4 und IPv6 und schreibt sie in einen A– und AAAA-Record. Da Upsert anlegt oder aktualisiert, läuft es beim ersten wie bei jedem weiteren Durchlauf gleich.

#!/bin/bash
set -euo pipefail

API_HOST="api.pph.systems"
API_TOKEN="sk_live_XXXX"
DOMAIN="deine-domain.de"
SUBDOMAIN="home"

updateRecord() {
  local type="$1" content="$2"
  local payload
  payload=$(jq -n \
    --arg name "$SUBDOMAIN" --arg type "$type" --arg content "$content" \
    '{record_name: $name, record_type: $type, record_content: $content}')

  curl -s --request PATCH \
    --url "https://${API_HOST}/api/domains/${DOMAIN}/record/upsert" \
    --header 'Accept: application/json' \
    --header "Authorization: Bearer ${API_TOKEN}" \
    --header 'Content-Type: application/json' \
    --data "$payload"
}

IPV4=$(curl --max-time 3 -4 -sL https://pph.sh/ip.php || true)
IPV6=$(curl --max-time 3 -6 -sL https://pph.sh/ip.php || true)

if [ -z "$IPV4" ] && [ -z "$IPV6" ]; then
  echo "Weder IPv4 noch IPv6 gefunden." >&2
  exit 1
fi

[ -n "$IPV4" ] && updateRecord "A" "$IPV4"
[ -n "$IPV6" ] && updateRecord "AAAA" "$IPV6"

Leg das Skript in einen Cronjob, und deine Subdomain zeigt immer auf deine aktuelle Anschluss-IP. Nutze dafür einen Token mit Schreibrechten, den du am besten per Gated Route nur auf die Upsert-Route und diese eine Domain einschränkst.

Wie geht es weiter?

Noch Fragen?

Technische Fragen zur API beantworten dir unsere Entwickler direkt in unserem Discord. Stell deine Frage im Entwickler-Channel und pinge das Dev-Team an.

API-Antworten und Fehler verstehen

Wie eine Antwort der API aufgebaut ist, woran du einen Fehler erkennst und was die einzelnen Fehlertypen bedeuten. Mit diesem Wissen baust du deine Integration robust und findest Probleme schnell.

  • Aufbau erfolgreicher Antworten
  • Die sechs Fehlertypen und ihre Statuscodes
  • Fehler-Header und die trace_id für den Support

Erfolgreiche Antworten

Nutzdaten liegen immer unter data. Eine einzelne Ressource steht als Objekt darin, eine Liste als Array.

{
  "data": {
    "id": 10001,
    "label": "mein-webserver",
    "status": "Active"
  }
}

Bei manchen Routen kommen zusätzliche Felder wie meta (etwa für Paginierung) oder message (ein erklärender Hinweis) dazu. Der data-Umschlag bleibt aber die Konstante, an der du dich orientierst.

Woran du einen Fehler erkennst

Fehler kommen ohne data-Umschlag. Stattdessen steht das Fehlerobjekt direkt auf oberster Ebene und beginnt immer mit error: true. Vier Felder sind bei jedem Fehler dabei:

  • error: immer true.
  • trace_id: eine eindeutige Kennung für genau diesen Fehler.
  • type: der Fehlertyp, siehe unten.
  • message: eine kurze, menschenlesbare Beschreibung.

Je nach Fehlertyp kommen weitere Felder hinzu. Beim fehlenden Bestätigungstoken sieht das zum Beispiel so aus:

{
  "error": true,
  "trace_id": "67d82f94-7a6f-40fe-a49f-6a10d888a52f",
  "type": "confirmation_error",
  "message": "Confirmation token not found by value.",
  "required_type": "reinstall_os",
  "required_id": "10001",
  "hint_route": "https://api.pph.systems/api/confirmation-token?for=reinstall_os&related_id=10001"
}

Werte deine Fehlerbehandlung immer über das Feld type aus, nicht über den Text in message. Der Typ ist stabil, die Formulierung der Nachricht kann sich ändern.

Die Fehlertypen im Überblick

Es gibt sechs Fehlertypen. Der HTTP-Statuscode dazu ist in der Regel wie folgt.

typeStatusBedeutungWas du tun kannst
authentication_error401Token fehlt, ist falsch oder wurde widerrufenToken prüfen und korrekt im Authorization-Header senden
access_denied403Der Token darf diese Route nicht nutzenBerechtigungen des Tokens prüfen, Gated Routes freigeben
entity_not_found404Die angefragte Ressource existiert nicht oder gehört dir nichtID prüfen
validation_error422Die Anfrage ist unvollständig oder ungültigFehlende oder falsche Parameter korrigieren
confirmation_error400Für eine kritische Aktion fehlt das BestätigungstokenToken erzeugen und im X-Confirmation-Token-Header senden
general_error500Ein unerwarteter Fehler auf unserer SeiteSpäter erneut versuchen, bei anhaltendem Fehler die trace_id an den Support geben

Zwei Beispiele, die dir am Anfang oft begegnen. Bei einer Route, die dein Token nicht nutzen darf:

{
  "error": true,
  "trace_id": "1b9d6bcd-bbfd-4b2d-9b5d-ab8dfbbd4bed",
  "type": "access_denied",
  "message": "Access to the route vps.status.reboot is denied."
}

Bei einer unvollständigen Anfrage:

{
  "error": true,
  "trace_id": "3f7c1e02-6a44-4c9a-8f1e-9b2d5c7a0e11",
  "type": "validation_error",
  "message": "The given data was invalid."
}

Fehler stehen auch in den Headern

Zusätzlich zum Body liefert jede Fehlerantwort drei Header. Praktisch, wenn du in einem Skript nur die Header prüfen willst, ohne den Body zu parsen.

  • X-Error-Type
  • X-Error-Message
  • X-Error-Trace-Id

Das maßgebliche Feld für deine Logik bleibt type im Body.

Rate-Limit

Jeder Token hat ein Anfragekontingent pro Zeitfenster. Zwei Header zeigen dir bei jeder Antwort deinen Stand:

  • ratelimit-limit: dein Kontingent im aktuellen Fenster.
  • ratelimit-remaining: wie viele Anfragen dir noch bleiben.

Ist das Kontingent aufgebraucht, antwortet die API mit HTTP 429. Warte in dem Fall kurz und wiederhole die Anfrage. Baue in automatisierten Abläufen am besten ein, dass ratelimit-remaining beobachtet wird, bevor es so weit kommt. Mehr dazu steht in Wie ist die API abgesichert?.

Die trace_id ist dein Draht zum Support

Jede Fehlermeldung enthält eine trace_id. Wir protokollieren Fehler serverseitig, und diese Kennung verbindet deine Fehlermeldung mit unserem Protokoll. Wenn du dich mit einem Problem an uns wendest, gib die trace_id mit an. So finden unsere Entwickler den Vorgang sofort, ohne raten zu müssen.

Wie geht es weiter?

Noch Fragen?

Technische Fragen zur API beantworten dir unsere Entwickler direkt in unserem Discord. Stell deine Frage im Entwickler-Channel und pinge das Dev-Team an.

Kritische Aktionen mit einem Bestätigungstoken freigeben

Manche Aktionen brauchen mehr als einen gültigen API-Token. Dieser Beitrag zeigt Schritt für Schritt, wie du für eine kritische Aktion ein Bestätigungstoken erzeugst und einlöst. Als Beispiel dient die Neuinstallation eines Servers.

  • Warum manche Aktionen zusätzlich bestätigt werden
  • Token per Webinterface oder API erzeugen
  • Token im X-Confirmation-Token-Header einlösen

Wann brauche ich ein Bestätigungstoken?

Kritische Aktionen mit Daten-, Kosten- oder Verfügbarkeitsfolgen verlangen zusätzlich zum API-Token ein Bestätigungstoken. Dazu gehören unter anderem: Backup oder Snapshot zurückspielen, Betriebssystem neu installieren, Serverausstattung ändern, Rescue-Modus aktivieren, ISO einbinden, neuen Server bestellen und ein Hosting sofort kündigen.

Warum das so gebaut ist, steht in Wie ist die API abgesichert?. Kurz gesagt: Selbst ein Token mit vollen Schreibrechten kann eine solche Aktion nicht in einem einzigen Schritt auslösen. Es braucht immer eine bewusste, zweite Bestätigung.

Der Ablauf in drei Schritten

  1. Du rufst die kritische Route auf. Ohne Bestätigungstoken lehnt die API ab und sagt dir, welches Token sie erwartet.
  2. Du erzeugst das passende Bestätigungstoken, im Webinterface oder per API.
  3. Du wiederholst den Aufruf und sendest das Token mit. Erst jetzt wird die Aktion ausgeführt.

Schritt 1: Aktion aufrufen, ohne Token

Du rufst die Neuinstallation auf, wie du es normal tun würdest.

curl --request POST \
  --url https://api.pph.systems/api/vps/10001/rebuild \
  --header 'Accept: application/json' \
  --header 'Authorization: Bearer sk_live_XXXX' \
  --data '{ "osid": "latest" }'

Die API führt nichts aus. Sie antwortet mit HTTP 400 und erklärt, was fehlt:

{
  "error": true,
  "type": "confirmation_error",
  "message": "Confirmation token not found by value.",
  "required_type": "reinstall_os",
  "required_id": "10001",
  "hint_route": "https://api.pph.systems/api/confirmation-token?for=reinstall_os&related_id=10001",
  "trace_id": "00000000-0000-0000-0000-000000000000"
}

Die Antwort ist selbsterklärend. required_type nennt die Art der Bestätigung, hier reinstall_os. required_id nennt die Ressource, hier den Server mit der ID 10001. hint_route liefert dir die fertige Adresse, unter der du das passende Token erzeugst.

Schritt 2: Bestätigungstoken erzeugen

Du hast zwei Wege.

Über das Webinterface

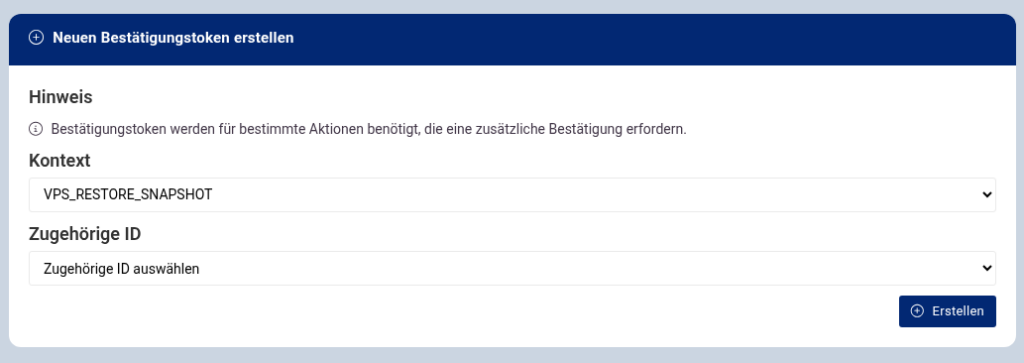
  1. Öffne in deinem Kundenbereich (Vionity) den Bereich API v2 und dort Neuen Bestätigungstoken erstellen.
  2. Wähle unter Kontext die Aktion aus. Für unser Beispiel ist das die Neuinstallation.
  3. Wähle unter Zugehörige ID den betroffenen Server aus.
  4. Klick auf Erstellen. Du erhältst den Token-Wert.

Über die API

Sende eine POST-Anfrage an die Adresse aus hint_route. Kontext und Ressource stehen als Parameter in der URL.

curl --request POST \
  --url 'https://api.pph.systems/api/confirmation-token?for=reinstall_os&related_id=10001' \
  --header 'Accept: application/json' \
  --header 'Authorization: Bearer sk_live_XXXX'

Die Antwort enthält den Token-Wert, zum Beispiel:

{
  "data": {
    "token": "ct_9f2c8a1b...",
    "for": "reinstall_os",
    "related_id": 10001,
    "expires_at": "2026-08-21T07:15:00.000000Z"
  }
}

Je nach Aktion kann das Erzeugen weitere Pflichtparameter verlangen. Die genaue Vorgabe zeigt dir die API-Dokumentation der jeweiligen Route.

Schritt 3: Token einlösen

Jetzt wiederholst du den Aufruf aus Schritt 1 und hängst den Token-Wert in den Header X-Confirmation-Token.

curl --request POST \
  --url https://api.pph.systems/api/vps/10001/rebuild \
  --header 'Accept: application/json' \
  --header 'Authorization: Bearer sk_live_XXXX' \
  --header 'X-Confirmation-Token: ct_9f2c8a1b...' \
  --data '{ "osid": "latest" }'

Passt das Token zu Aktion und Ressource und ist es noch gültig, nimmt die API die Anfrage an und die Aktion startet.

Eigenschaften des Bestätigungstokens

  • Fest gebunden: Ein Token gilt nur für genau eine Aktion (for) und genau eine Ressource (related_id). Für einen anderen Server oder eine andere Aktion brauchst du ein neues Token. Für VPS Order gibst du Hosting „0“ an.
  • Einmalig: Nach dem Einlösen ist der Token verbraucht.
  • Zeitbegrenzt: Nach Ablauf wird der Token abgewiesen und du erzeugst einen neuen.

Diese drei Eigenschaften zusammen sorgen dafür, dass eine Bestätigung nicht versehentlich wiederverwendet oder auf eine andere Ressource umgemünzt werden kann.

Komfortabler per Direktlink (Coming soon)

Künftig kann ein automatisierter Ablauf, etwa ein KI-Assistent, dir einen vorausgefüllten Vionity-Link schicken, statt das Token selbst zu erzeugen. Du öffnest den Link, das Formular ist bereits mit Kontext und zugehöriger Ressource befüllt, und du erhältst ein zeitbegrenztes Einmaltoken für genau diese Aktion. Dieses Token trägst du dann als X-Confirmation-Token in den Aufruf ein.

Der Vorteil: Die eigentliche Freigabe passiert bei dir im Browser, nicht im automatisierten Client. So bleibt die Kontrolle über kritische Aktionen bei dir, selbst wenn der Client vollautomatisch läuft.

Wie geht es weiter?

Noch Fragen?

Technische Fragen zur API beantworten dir unsere Entwickler direkt in unserem Discord. Stell deine Frage im Entwickler-Channel und pinge das Dev-Team an.

Meine erste API-Anfrage: der Quickstart

Alles klar, lass uns JSON sprechen: In fünf Minuten von null zur ersten Antwort. Du fragst deinen Account ab, listest deine Server und siehst live, was einer davon gerade macht. Alles nur lesend, du kannst also nichts kaputt machen.

  • Erste Anfrage mit curl
  • Account, Server und Live-Status abfragen
  • Read-only, ideal zum Ausprobieren

Was du brauchst

Einen API-Token. Wie du ihn erstellst, steht in Wie erhalte ich einen API Key?. Für diesen Quickstart reicht ein Token mit Nur Lesezugriff.

Basis-URL ist https://api.pph.systems/api. Deinen Token schickst du bei jeder Anfrage im Authorization-Header mit. In den Beispielen steht sk_live_XXXX als Platzhalter, dort gehört dein echter Token hin.

Schritt 1: Wer bin ich?

Die einfachste Anfrage überhaupt. Sie gibt dein Kundenprofil zurück und bestätigt, dass dein Token funktioniert.

curl --request GET \
  --url https://api.pph.systems/api/client \
  --header 'Accept: application/json' \
  --header 'Authorization: Bearer sk_live_XXXX'

Antwort:

{
  "data": {
    "id": 12345,
    "full_name": "Max Mustermann",
    "email": "max@example.com",
    "contact": {
      "firstname": "Max",
      "lastname": "Mustermann",
      "address1": "Beispielstraße 1",
      "postcode": "12345",
      "city": "Musterstadt",
      "country": "DE"
    },
    "credit": 25,
    "pph_pro": "none",
    "datecreated": "2022-01-15T00:00:00.000000Z",
    "lastlogin": "2026-08-21T05:17:27.000000Z"
  }
}

Wichtig ist das Grundmuster: Nutzdaten liegen immer unter data. Bekommst du hier eine gültige Antwort, ist dein Zugang eingerichtet.

Ein Fehler würde so aussehen:

{
  "error": true,
  "trace_id": "342b318d-bbb6-4421-9a18-75ebb5d0b999",
  "type": "general_error",
  "message": "Invalid API token",
  "exception_class": "Exception"
}

Schritt 2: Welche Server habe ich?

Jetzt wird es interessant. Diese Route listet alle deine virtuellen Server auf einen Schlag.

curl --request GET \
  --url https://api.pph.systems/api/vps \
  --header 'Accept: application/json' \
  --header 'Authorization: Bearer sk_live_XXXX'

Antwort (gekürzt):

{
  "data": [
    {
      "id": 10001,
      "product": { "name": "KVM Konfigurierbar 3.5", "group": "AMD SSD KVM vServer" },
      "label": "mein-webserver",
      "domain": "10001-00000.pph-server.de",
      "status": "Active",
      "ipaddress": "192.0.2.10",
      "additional_ips": ["2001:db8:4a3c::1"],
      "description": ["Linux", "4 Cores", "2 GB RAM", "50 GB NVMe"]
    },
    {
      "id": 10002,
      "product": { "name": "Ryzen 1", "group": "Ryzen Compute" },
      "label": "Ryzekocher",
      "domain": "10002-00000.pph-server.de",
      "status": "Active",
      "ipaddress": "192.0.2.36",
      "additional_ips": null,
      "description": []
    }
  ]
}

Jeder Server liefert noch mehr Felder, etwa zur Abrechnung, zur Konfiguration und zu gesetzten Tags. Für den Anfang zählt die id. Die brauchst du für alle serverbezogenen Anfragen im nächsten Schritt.

Schritt 3: Was macht mein Server gerade?

Nimm eine id aus der Liste und häng sie an die Status-Route. Du bekommst den Live-Zustand des Servers.

curl --request GET \
  --url https://api.pph.systems/api/vps/10001/status \
  --header 'Accept: application/json' \
  --header 'Authorization: Bearer sk_live_XXXX'

Antwort:

{
  "data": {
    "host": {
      "status": "running",
      "locked": false,
      "rescue": false
    },
    "running_tasks": 0,
    "state": {
      "is_rebuilding": false,
      "is_in_rescue_mode": false,
      "is_backing_up": false,
      "is_running": true,
      "is_stopped": false
    },
    "os_type": {
      "name": "debian",
      "type": "linux"
    },
    "last_start": {
      "time": "2026-08-16 14:47:37",
      "human_readable": "4 days ago"
    },
    "last_backup": {
      "time": "2026-08-20 20:00:18",
      "human_readable": "10 hours ago"
    }
  }
}

Auf einen Blick siehst du, ob der Server läuft (state.is_running), ob gerade eine Aktion aktiv ist (running_tasks) und wann das letzte Backup lief (last_backup). Genau das ist der Baustein, aus dem du dir in wenigen Zeilen dein eigenes Status-Dashboard baust.

Nichts kaputt zu machen

Alle drei Anfragen sind reine Leseanfragen. Mit einem Read-only-Token kannst du sie gefahrlos so oft wiederholen, wie du willst (und dein Quota zulässt). Nutze das, um dich mit dem Antwortformat vertraut zu machen, bevor du zu schreibenden Routen übergehst.

Wie geht es weiter?

Noch Fragen?

Technische Fragen zur API beantworten dir unsere Entwickler direkt in unserem Discord. Stell deine Frage im Entwickler-Channel und pinge das Dev-Team an.

Was kann die Prepaid-Hoster API?

Ein Überblick, was du mit der Prepaid-Hoster API v2 steuern kannst. Kurz gesagt: fast alles aus deinem Kundenbereich, nur eben per Code.

  • Server, Domains und Account programmatisch steuern
  • Über 140 Routen, REST und JSON
  • Bring your own Webinterface

Die Idee dahinter

Alles, was du im Webinterface klickst, kannst du auch per API auslösen. Damit baust du dir Automatisierungen, Monitoring oder gleich deinen eigenen Cloud-Manager. Die API ist REST-basiert, spricht JSON und deckt aktuell über 140 Routen ab.

Basis-URL: https://api.pph.systems/api

Server steuern

  • Starten, stoppen, neu starten und hart zurücksetzen
  • Betriebssystem neu installieren
  • Ressourcen ändern (CPU, RAM, Storage)
  • Live-Auslastung, Uptime, Traffic und historische Statistiken auslesen
  • Diagnose: Ping, Portscan, laufende Prozesse

Sichern und wiederherstellen

  • Backups und Snapshots anlegen
  • Backups zurückspielen, auch auf einen anderen Server
  • Snapshots wiederherstellen

Zugriff und Rettung

  • VNC-Konsole und (bei Windows) RDP-Zugang
  • SSH-Port, Root-Login und SSH-Keys verwalten
  • Rescue-Modus für Reparaturen aktivieren
  • Reverse DNS setzen

Domains und DNS

  • Domainverfügbarkeit prüfen, registrieren und transferieren
  • DNS-Records anlegen, ändern, im- und exportieren
  • Nameserver und DNSSEC verwalten
  • Registry-Infos und Transfer-Auth-Code abrufen

Account

  • Rechnungen, Transaktionen und Belege einsehen
  • Guthaben auf Rechnungen anwenden
  • Support-Tickets und System-Mails abrufen

Bestellen

  • Verfügbare Produkte und Optionen abfragen
  • Preis vorab berechnen
  • Neuen Server konfigurieren und bestellen

Zwei Dinge, die kaum ein Hoster kann

Eigenes ISO booten. Du bindest ein beliebiges ISO-Image ein (http-Link benötigt) und installierst dein Wunsch-Betriebssystem selbst. Kein Warten auf ein passendes Template oder Support-Tickets.

Befehle direkt im Server ausführen. Über den Guest-Agent schreibst und liest du Dateien und startest Kommandos oder Skripte im laufenden Server, ohne dich per SSH einzuloggen. Längere Läufe fragst du per Polling ab und holst dir die Ausgabe.

Und die Sicherheit?

Jeder Token bekommt nur die Rechte, die er braucht. Read oder Write, gezielt freigegebene Routen, Bindung an einzelne Server oder Domains und ein Bestätigungstoken für kritische Aktionen. Details stehen im Beitrag Wie ist die API abgesichert?.

Loslegen

Wie du deinen ersten Token erstellst, steht in Wie erhalte ich einen API Key?.

Noch Fragen?

Technische Fragen zur API beantworten dir unsere Entwickler direkt in unserem Discord. Stell deine Frage im Entwickler-Channel und pinge das Dev-Team an.

Wie ist die Prepaid-Hoster API abgesichert?

Das Sicherheitskonzept der API v2: Berechtigungsstufen, Gated Routes, Bestätigungstoken und Rate-Limits im Überblick.

  • Least Privilege per Token
  • Bestätigungstoken für zerstörerische Aktionen
  • Ressourcen-Pinning und Rate-Limits

Auf einen Blick

Die Prepaid-Hoster API v2 ist mehrschichtig abgesichert. Jede Schicht lässt sich pro Token einzeln setzen, sodass ein Key immer nur genau das kann, was dein Anwendungsfall braucht.

  • Berechtigungsstufe: Lesezugriff oder Schreibzugriff.
  • Gated Routes: Freigabe einzelner Routen oder ganzer Routengruppen per Wildcard.
  • Ressourcen-Pinning: Bindung einer Route an konkrete Hosting- oder Domain-IDs.
  • Bestätigungstoken: Zusätzliche Freigabe für kritische Aktionen mit Daten-, Kosten- oder Verfügbarkeitsfolgen.
  • Rate-Limits: Feste Anfragekontingente pro Zeitfenster, mit separatem Kontingent für DNS.
  • MCP-Zugriff: Standardmäßig deaktiviert, nur auf Anfrage freischaltbar.

Wie du einen Token anlegst und die Grundoptionen setzt, steht im Einstiegsartikel Wie erhalte ich einen API Key?. Dieser Beitrag erklärt, wie die Absicherung dahinter funktioniert.

Hinweis: Die API befindet sich aktuell noch in der Entwicklung. Einzelne Mechanismen können sich noch ändern. Die hier beschriebenen Grundprinzipien bleiben bestehen.

Grundprinzip: so wenig Rechte wie möglich

Ein API-Token ist ein Zugang zu deinem Account. Kompromittiert jemand einen Token, kann er alles tun, was der Token darf. Deshalb gilt für jeden Token dieselbe Faustregel: Vergib nur die Rechte, die der konkrete Anwendungsfall wirklich braucht.

Ein Monitoring-Skript braucht keinen Schreibzugriff. Ein Backup-Skript für einen einzelnen Server braucht keinen Zugriff auf alle deine Dienste. Je enger du einen Token schneidest, desto kleiner ist der Schaden, falls er verloren geht.

Berechtigungsstufe: Lesen oder Schreiben

Jeder Token hat eine von zwei Stufen:

  • Nur Lesezugriff: Der Token darf Daten ausschließlich abfragen. Alle schreibenden Routen werden abgewiesen.
  • Mit Schreibrechten: Der Token darf zusätzlich Daten anlegen, ändern und löschen.

Diese Stufe ist die grobe Weiche. Alles Weitere schränkt den Zugriff innerhalb der gewählten Stufe weiter ein.

Gated Routes und Ressourcen-Pinning

Standardmäßig darf ein Token alle Routen ansprechen, die seine Berechtigungsstufe erlaubt. Mit Gated Routes drehst du das um: Ist die Funktion aktiv, darf der Token nur noch die Routen nutzen, die du explizit freigibst. Jeder andere Aufruf wird mit HTTP 403 abgewiesen, inklusive des kanonischen Routennamens in der Fehlermeldung.

Freigeben kannst du auf zwei Arten, die sich kombinieren lassen:

  • Wildcards: vps.status.index gibt genau eine Route frei. vps.* gibt alle VPS-Routen frei. domains.records.* gibt alle DNS-Record-Routen frei.
  • Ressourcen-Pinning: Über Hosting IDs und Domain IDs bindest du eine freigegebene Route an konkrete Ressourcen. Der Token nutzt die Route dann nur für genau diese IDs.

So baust du dir zum Beispiel einen Token, der vps.* darf, aber ausschließlich auf einem einzigen Server.

Bestätigungstoken für kritische Aktionen

Manche Aktionen haben Folgen, die sich nicht einfach zurücknehmen lassen. Sie überschreiben Daten, lösen Kosten aus oder greifen in die Verfügbarkeit eines Servers ein. Für diese Routen reicht ein gültiger API-Token allein nicht aus. Sie verlangen zusätzlich ein Bestätigungstoken.

Aktuell brauchen diese Aktionen ein Bestätigungstoken:

  • Ein Backup zurückspielen, auf denselben oder auf einen anderen Server
  • Einen Snapshot zurückspielen
  • Das Betriebssystem neu installieren (Rebuild)
  • Die Ausstattung eines Servers ändern (CPU, RAM, Storage)
  • Den Rescue-Modus aktivieren
  • Ein ISO einbinden und den zugehörigen Boot-Vorgang starten
  • Einen neuen Server bestellen
  • Ein Hosting sofort kündigen

Der Ablauf ist immer gleich:

  1. Du rufst eine dieser Routen ohne Bestätigungstoken auf. Die API führt die Aktion nicht aus, sondern weist darauf hin, dass eine Bestätigung nötig ist.
  2. Du erzeugst ein Bestätigungstoken für genau diese Aktion. Das geht über das Webinterface oder über die API selbst.
  3. Du wiederholst die Anfrage und sendest das Bestätigungstoken mit. Erst jetzt wird die Aktion ausgeführt.

Das Bestätigungstoken ist kurzlebig und an die konkrete Aktion gebunden. Der Sinn dahinter: Selbst ein Token mit vollen Schreibrechten kann nicht versehentlich oder durch einen Fehler im automatisierten Ablauf eine solche Aktion auslösen. Es braucht immer einen zweiten, bewussten Schritt.

Das ist besonders für automatisiert laufende Keys wertvoll. Ein Cronjob oder ein agentischer Client kann seine Routine abarbeiten, kommt aber an einer kritischen Aktion nicht ohne den zusätzlichen Bestätigungsschritt vorbei.

P.S.: Bei Domains wird vor zerstörerischen Aktionen automatisch ein nicht löschbarer Snapshot deiner Records angelegt, den du jederzeit per API zurückspielen kannst.

Human in the loop (Coming soon)

Die nächste Ausbaustufe des Bestätigungssystems ist Human in the loop. Aktivierst du sie für einen Token, wird die Bestätigung aus dem technischen Ablauf herausgelöst und an einen Menschen übergeben.

Statt dass der Client sich das Bestätigungstoken selbst generiert, geht bei einer kritischen Aktion eine Nachricht mit einem Bestätigungslink an dich, zum Beispiel per E-Mail. Erst wenn du den Link öffnest und die Aktion freigibst, wird sie ausgeführt. Lehnst du ab oder reagierst du nicht, verfällt die Anfrage. Das ist besonders für agentische Aktionen von Vorteil.

Der entscheidende Punkt: Der Bestätigungslink geht nie an den API-Client zurück. Ein automatisierter Ablauf kann die Freigabe also nicht selbst erteilen. Die Kontrolle über kritische Aktionen bleibt beim Kontoinhaber, auch wenn ein Token vollautomatisch läuft oder in falsche Hände gerät.

Rate-Limits

Jeder Token unterliegt einem Anfragekontingent pro Zeitfenster. Das schützt die Plattform vor Überlastung und begrenzt den Schaden durch einen außer Kontrolle geratenen oder missbrauchten Token.

  • Das allgemeine Kontingent liegt aktuell bei 100 Anfragen pro 60 Sekunden.
  • DNS-Endpunkte haben ein zusätzliches, separates Kontingent, damit DNS-Änderungen die allgemeine Quote nicht aufbrauchen.
  • Das Kontingent skaliert mit der Anzahl deiner aktiven Dienste.

Jede Antwort enthält die Header ratelimit-limit und ratelimit-remaining, an denen du deinen aktuellen Stand ablesen kannst. Dein exaktes Kontingent und die Sekunden bis zum Reset fragst du jederzeit über die Quota-Route deines Tokens ab.

MCP-Zugriff ist opt-in

Tokens lassen sich optional für die Nutzung mit MCP-Servern (Model Context Protocol) freischalten, etwa um die API an einen KI-Assistenten anzubinden. Diese Fähigkeit ist bewusst standardmäßig nicht verfügbar und wird pro Account manuell freigeschaltet.

Der Grund: Ein KI-Assistent, der im Namen deines Accounts handelt, verschiebt einen Teil der Verantwortung. Vor der Freischaltung klären wir dich über die Konsequenzen auf und holen deine Zustimmung ein. In Kombination mit Schreibzugriff greift hier zusätzlich das Bestätigungstoken-System als Schutzschicht. Wenn du MCP nutzen möchtest, melde dich beim Support.

Fähigkeiten eines Tokens einsehen

Du musst nicht raten, was ein Token darf. Die API liefert dir die vollständigen Fähigkeiten deines Tokens zurück:

{
  "description": "Backup-Skript",
  "token_create_date": "2026-08-14T09:00:59.000000Z",
  "token_expiration_date": null,
  "token_last_used_date": "2026-08-21T06:31:43.000000Z",
  "capabilities": {
    "mcp_access": false,
    "write_access": true,
    "routes": "*",
    "expanded_routes": [],
    "confirmation_tokens": {
      "human_in_the_loop": false,
      "human_in_the_loop_config": null
    }
  }
}

Die Felder im Einzelnen:

  • write_access: Ob der Token schreiben darf oder nur liest.
  • routes: Die freigegebenen Routen. * bedeutet alle, andernfalls stehen hier deine Gated Routes.
  • expanded_routes: Deine Wildcards in aufgelöster Form, also die einzelnen Routen, die eine Regel wie vps.* tatsächlich abdeckt.
  • mcp_access: Ob der Token für MCP freigeschaltet ist.
  • confirmation_tokens.human_in_the_loop: Ob für diesen Token die Bestätigung per Mensch aktiv ist.
  • token_last_used_date: Wann der Token zuletzt genutzt wurde. Praktisch, um verwaiste Tokens zu erkennen.

Token-Lebenszyklus und Widerruf

Ein Token bleibt gültig, bis du ihn widerrufst oder ein gesetztes Ablaufdatum erreicht ist. Zwei Empfehlungen für den Alltag:

  • Prüfe über token_last_used_date regelmäßig, ob deine Tokens noch aktiv genutzt werden. Einen nicht verwendeten Token solltest du widerrufen.
  • Nutze getrennte Tokens für getrennte Aufgaben. So kannst du einen einzelnen kompromittierten oder nicht mehr benötigten Token widerrufen, ohne alle anderen Integrationen zu stören. Es gibt kein Token-Limit.

Einen Token deaktivierst du sofort, indem du in den API-Token Details den Haken bei Token widerrufen setzt und speicherst. Ein widerrufener Token wird ab der nächsten Anfrage abgewiesen.

Nachvollziehbarkeit (Coming soon)

Demnächst kannst du Aktionen und Logs deiner Tokens direkt im Webinterface einsehen. Du siehst dann, welche Aktion wann über welchen Token ausgeführt wurde. Das erleichtert die Fehlersuche und macht auffällige Zugriffe schnell sichtbar.

Noch Fragen?

Technische Fragen zur API beantworten dir unsere Entwickler direkt in unserem Discord. Stell deine Frage im Entwickler-Channel und pinge das Dev-Team an.